Angewandte Statistik ist eine Schlüsselqualifikation in Forschung und Entwicklung. Vom Aufbau von Experimenten mit ausreichender statistischer Aussagekraft in der frühen Forschung bis hin zur Designuntersuchung, Optimierung und Toleranzanalyse in der Entwicklung und Konstruktion – alle Phasen der F&E profitieren von der korrekten Anwendung geeigneter statistischer Werkzeuge.
Dieses Training zeichnet sich aus durch:
- Praktisches F&E-Toolkit: Kombination von GRR-Messfehlern, Konfidenzintervallen, Schätzung des Stichprobenumfangs, DOE, Multi-Response-Optimierung, Monte-Carlo-Toleranz – zugeschnitten auf den Kontext von Forschung und Produktentwicklung.
- Praktische Minitab/Excel-Übungen: gewährleistet die sofortige Anwendung der Kenntnisse.
- Hands on fun Gage R&R Übung, Hands on fun DOE/ Optimierungsübung
- Praktische Übungen mit Beispielen für gängige technische Berechnungen zum Nachschlagen.
- Trainerin und renommierte Expertin Wendy Luiten, die durch ihre jahrzehntelange Erfahrung in der Branche über umfangreiche Kenntnisse verfügt.
In der Forschung und frühen Entwicklung wird die Messstatistik verwendet, um den Messfehler zu ermitteln und anschließend eine Stichprobengröße zu berechnen, die groß genug ist, um eine ausreichende statistische Aussagekraft zu erhalten – die Fähigkeit, einen Effekt zu erkennen, wenn er vorhanden ist. Bei der Verwendung von Doppelmessungen zum Beispiel liegt die Aussagekraft, einen Unterschied zwischen zwei Prototypen zu finden, wenn der Unterschied ungefähr dem Messfehler entspricht, unter 10%. Experimente mit zu geringer Aussagekraft sind unerwünscht, da sie zu einer Verschwendung von Zeit und Geld führen. Die Durchführung eines Experiments mit zu geringer Aussagekraft hat keinen Sinn, da es kein wiederholbares Ergebnis liefert. Stattdessen muss entweder die Messung verbessert werden, um den Fehler zu verringern, oder die Stichprobengröße muss erhöht werden, d.h. die Experimente müssen häufiger wiederholt werden.
In der späteren Entwicklung und im Ingenieurwesen zielen Aktivitäten darauf ab, eine Funktion in Form eines bestimmten Ausgabeparameters zu erfüllen, der innerhalb eines erforderlichen Bereichs liegt. Die Ausfallrate ist der Anteil der Fälle, in denen die Ausgabe außerhalb des gewünschten Spezifikationsfensters liegt und die beabsichtigte Funktion nicht wie gewünscht erfüllt wird. Eine hohe Ausfallrate ist unerwünscht, sie ist ein Zeichen für schlechte Qualität und zieht finanzielle Konsequenzen nach sich.
Ein Teil der Ausfallrate ist ‚eingebaut‘ – sie ist das Ergebnis einer Kombination aus Designentscheidungen und Design-Eingangsvariationen, die zu einer Verteilung der Ausgangsparameter führt, die teilweise außerhalb der Spezifikationsgrenzen liegt. Eine direkte Messung dieser Ausfallrate als Richtschnur für Designentscheidungen ist in der Regel nicht möglich, da dafür zu viele Tests erforderlich sind. Eine Ausfallrate von 1 % bedeutet beispielsweise, dass im Durchschnitt 100 Tests durchgeführt werden müssen, um 1 Ausfall festzustellen. Um die eingeplante Ausfallrate genau zu erkennen, sind viel mehr Tests erforderlich, und das ist im Allgemeinen nicht machbar. Daraus ergibt sich ein Dilemma: Bis Sie genügend Daten über die Ausfallrate haben, ist das Zeitfenster für Änderungen am Design bereits geschlossen.
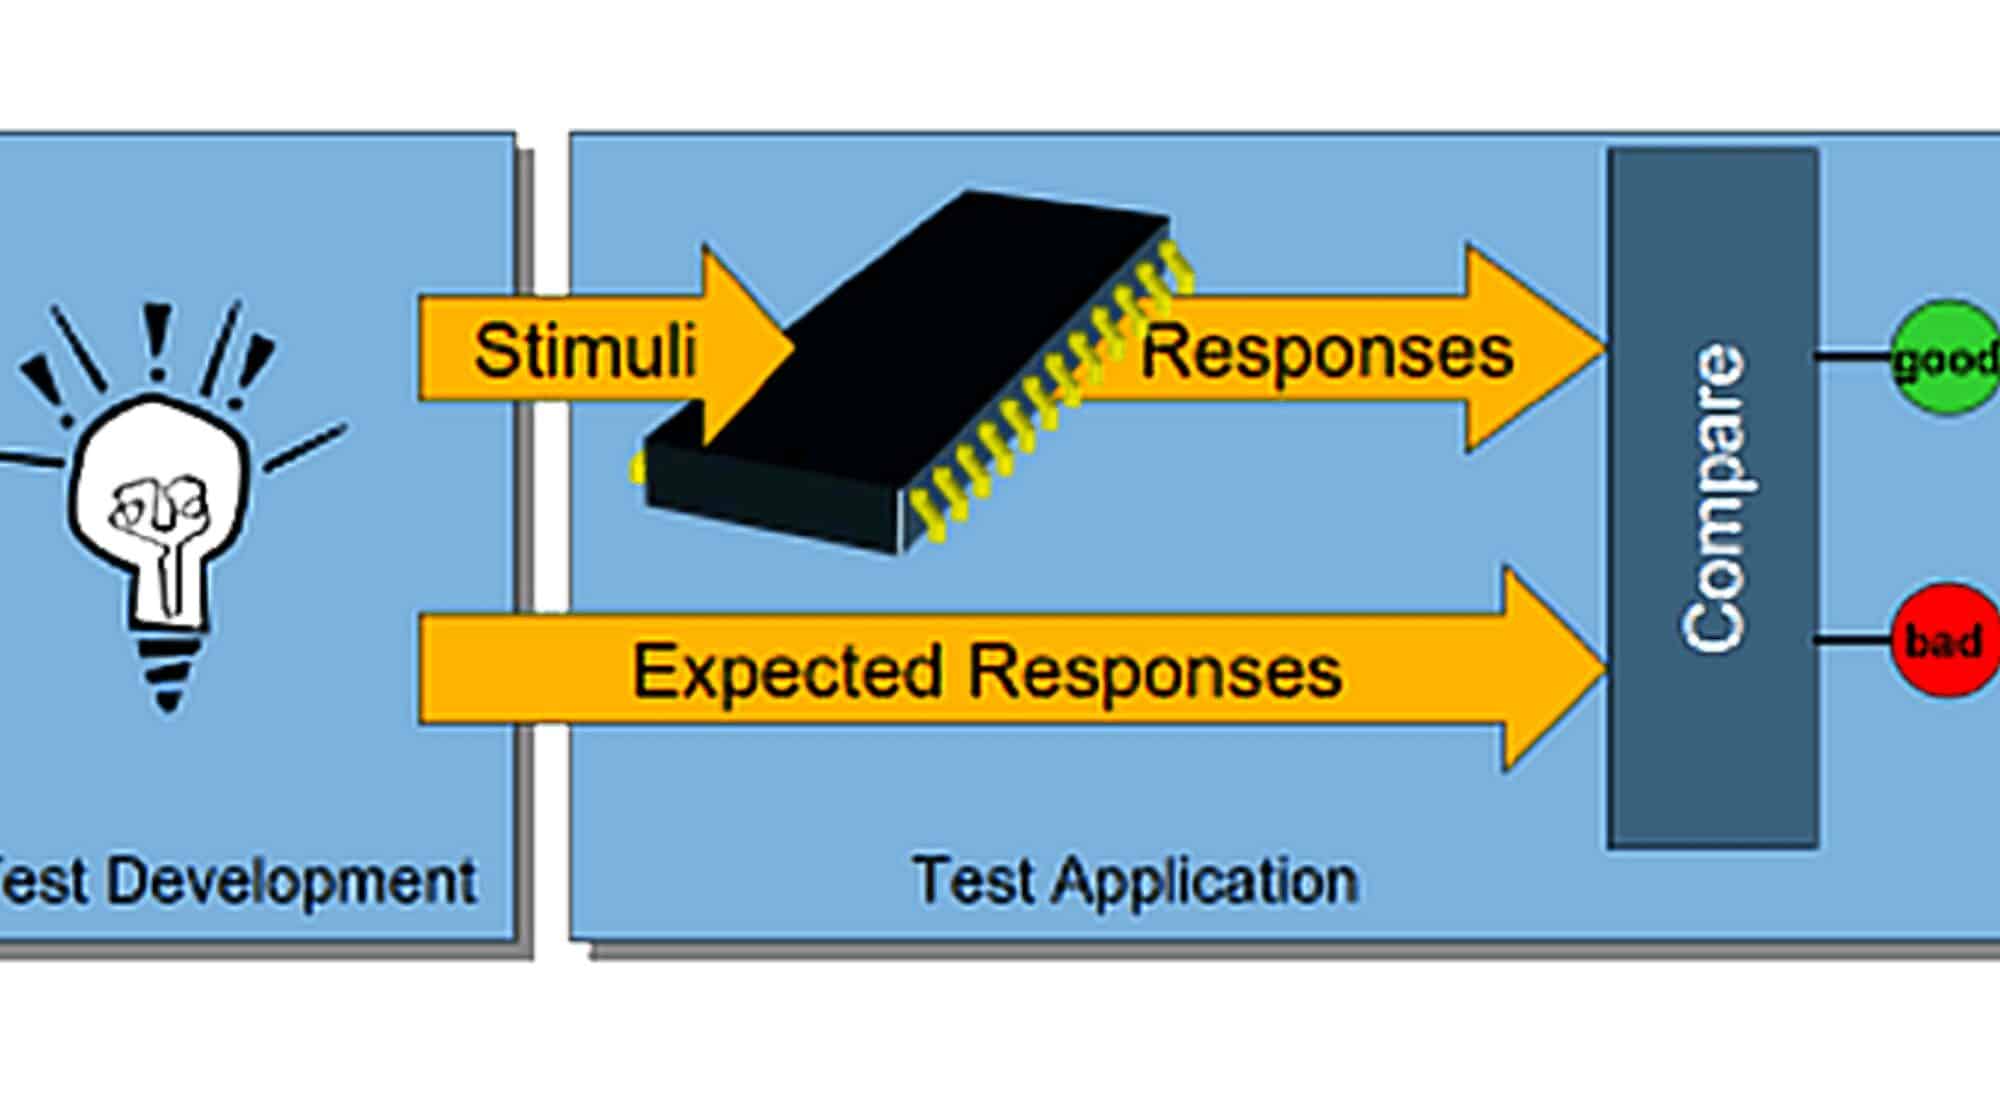
Das Timing-Dilemma ist keine Seltenheit und nicht auf statistische Parameter beschränkt. Die allgemeine Lösung besteht darin, einen Ersatz zu verwenden und auf die Modellierung zurückzugreifen, wobei berechnete Werte anstelle von Messdaten verwendet werden. CAD-Modellierung, Schaltkreismodellierung, FEM-Modellierung und CFD-Modellierung sind alles Beispiele, bei denen ein Modell verwendet wird, um ein Design zu bewerten, bevor ein direkter Test möglich ist. In gleicher Weise wird die statistische Modellierung verwendet, um das statistische Verhalten eines Entwurfs zu untersuchen, wenn Tests nicht möglich sind. Statistische Modellierung ist die Grundlage für Designoptimierung und robustes Design. Spezifische Versuchspläne werden verwendet, um Ersatzfunktionen abzuleiten, die die erwarteten Ausgabewerte als Funktion der Design-Inputs modellieren. Anschließend werden die Ersatzfunktionen zur Optimierung verwendet. Schließlich werden die erwartete Verteilung der Ausgangsparameter und die daraus resultierende Ausfallrate aus der Surrogatfunktion und der Verteilung der Eingangsparameter ermittelt.
Diese Schulung soll die Teilnehmer mit den relevanten statistischen Werkzeugen und der Arbeitsweise bei der Verwendung verknüpfter statistischer Werkzeuge in ihrer täglichen Arbeit vertraut machen. Der Trainer ist ein zertifizierter Master Black Belt in Design for Six Sigma mit mehr als 35 Jahren Industrieerfahrung in Forschung und Entwicklung. Alle Statistiken werden mit Minitab (Industriestandard) und Excel demonstriert. Die Schulung enthält Übungen zu den einzelnen statistischen Werkzeugen und eine Gruppenübung, in der die Arbeitsweise unter gemeinsamer Verwendung der Werkzeuge geübt wird. Der Schwerpunkt der Schulung liegt auf der korrekten Anwendung geeigneter statistischer Werkzeuge, um Entwicklungsziele zu erreichen: „Sie müssen nicht die Funktionsweise des Motors kennen, um ein Auto von A nach B zu fahren„. Die Schulung bezieht sich auf kontinuierliche numerische Parameter und umfasst sowohl physikalische Experimente als auch virtuelle Experimente wie CFD- oder FEM-Simulationen.
Diese Schulung wird sowohl als offene Schulung in Eindhoven als auch als firmeneigene Schulung weltweit angeboten. Bei firmeneigenen Schulungen kann die Schulung an Ihre Situation und Ihre spezifischen Anforderungen angepasst werden.